エージェントをより良く評価する
ソフトウェア実験をより信頼しやすくする。
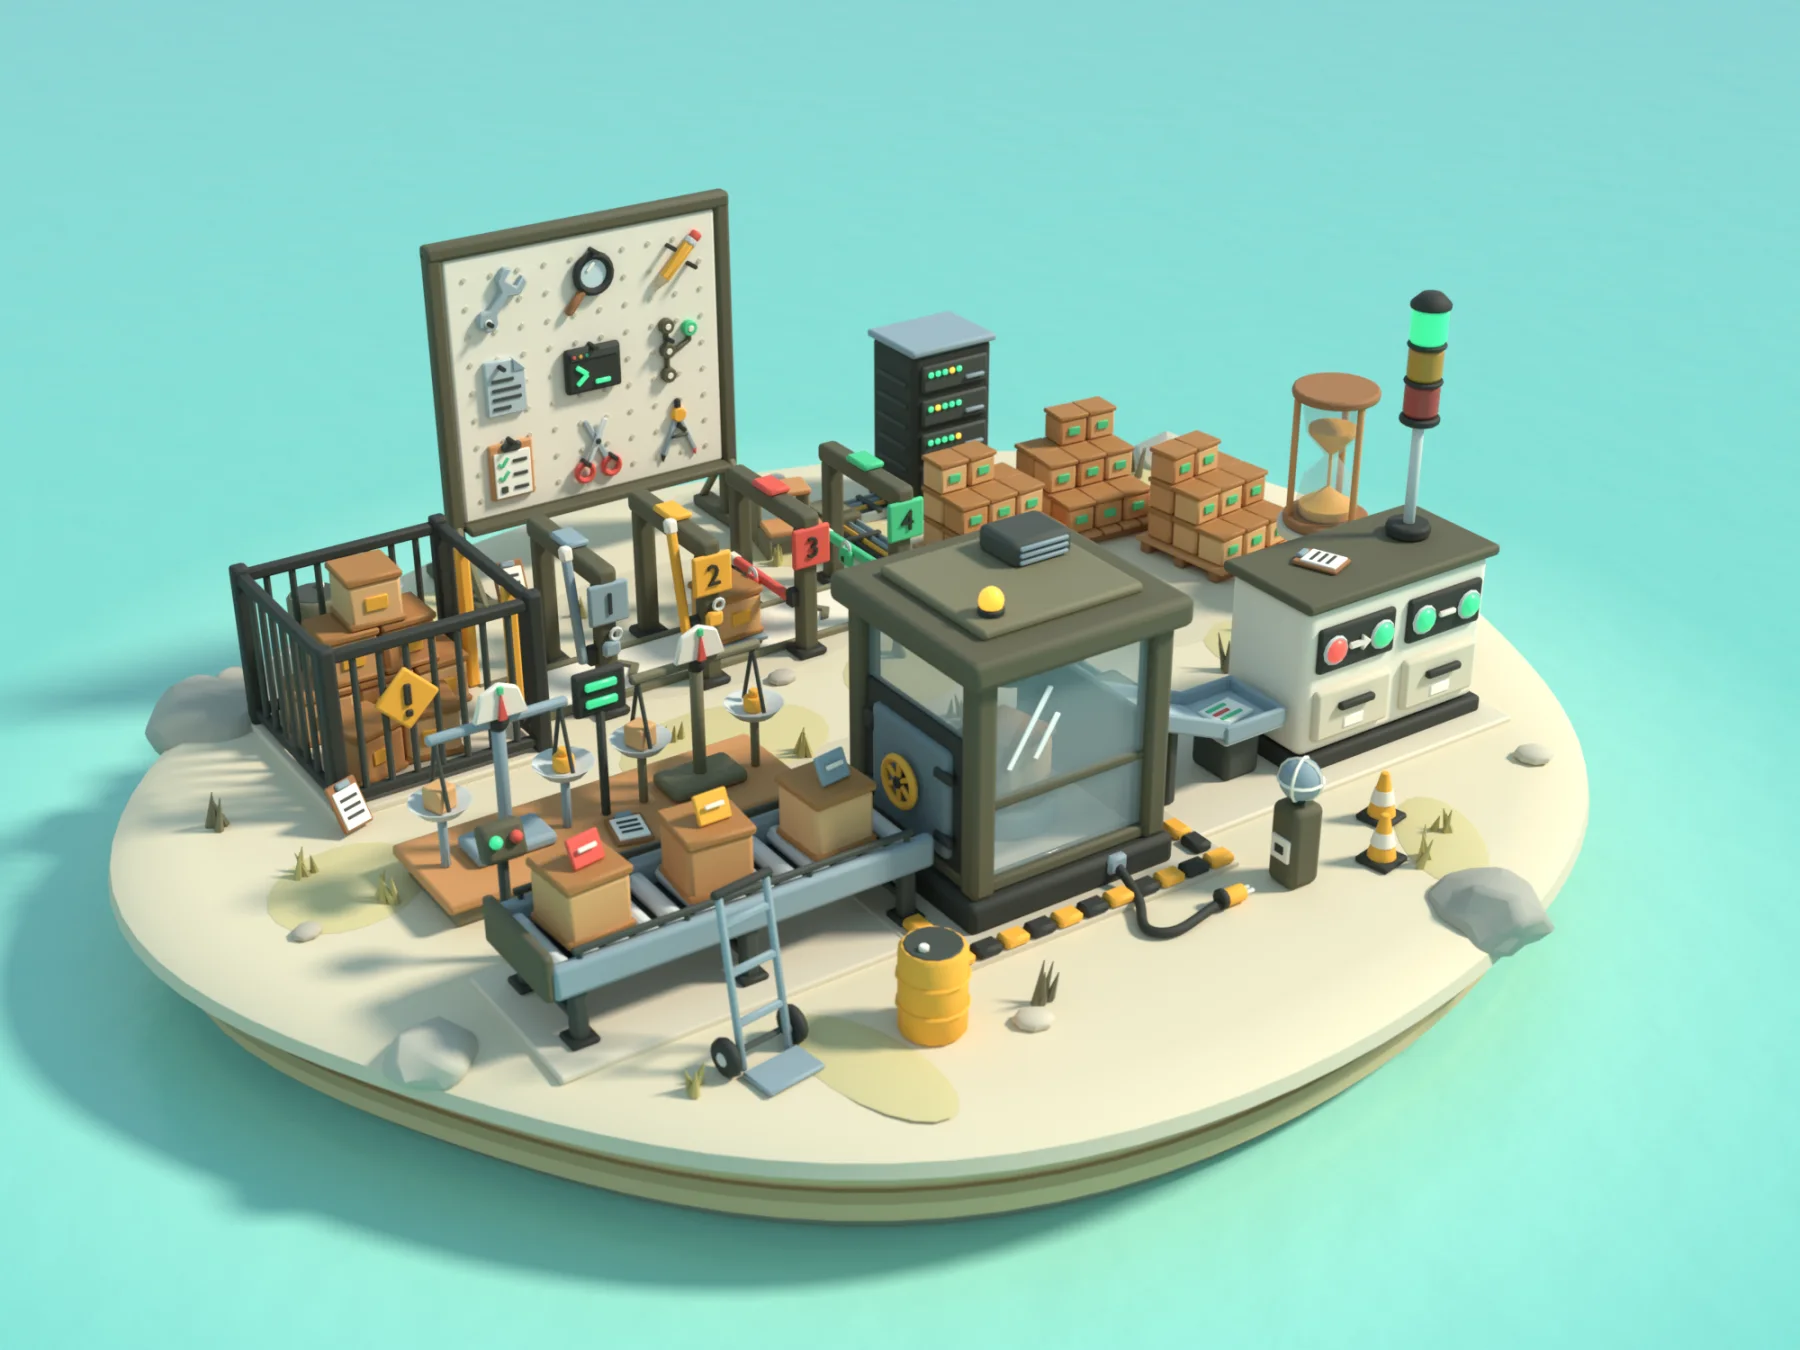
テストの列、隔離用の囲い、そして九つのツールが並ぶ壁。
このサイトのために Blender で制作したイラストです。考え方を説明するためのもので、プロジェクトのデータではありません。
プロジェクトの画像・図・動画は原文のまま掲載しています。
コーディングエージェントが向上したかを問う前に、何でテストされたのかを正確に知っておくことが役立ちます。このプロジェクトは、Gemma 4 をベースにしたリポジトリ修復エージェントについて、その問いを支える基盤を構築します。タスクの来歴、評価の隔離、決定論的な学習スケジュール、復旧可能な実行です。基本ルールは、検証されていないステップの上にどんな主張も置かないことです。
テストされる仕事
エージェントには、実在するオープンソースのリポジトリと、報告済みの issue が与えられます。使えるのはちょうど九つのツールで、コマンドの実行、ファイルの読み取りと編集、状態の確認、コード構造のナビゲーション、パッチの提出をカバーしています。パッチが正しいかどうかは、エージェントが一度も目にしないテストによって判定されます。
密閉された部屋と二種類のテスト
各タスクは、ネットワークを切断したコンテナ内で実行されます。有効なタスクは、修正前には失敗し、修正後には成功しなければなりません。失敗していたテストは成功するようになり、成功していたテストは引き続き成功する必要があります。五つのテストフレームワークに対応するパーサーがケースごとの結果を読み取り、合計値が個々のケースと矛盾する集計は却下します。
各タスクがどこから来たのかを知る
32,079 件の候補行のうち 4,818 件が要件を満たし、そのうち 2,966 件を選んで、学習用・開発用・確認用の分割に固定しました。分割はリポジトリ単位と所有者単位で分けているため、同じプロジェクトが両側に現れることはありません。ライセンスファイルは各タスクの固定コミットの時点で確認しました。その結果、寛容型ライセンスの表示がありながらコピーレフトの文言を含むリポジトリが四つ見つかりました。
四つの関門と二つのチェッカー
学習例は隔離された状態から始まり、四つの関門を通過して初めて受け入れられます。権利と帰属表示、分割の隔離、実行環境での適格性、タスクとの整合性です。その後、独立した監査モジュールがローダーとコードを共有せずにすべての量を再計算するため、両者は独立して一致しなければなりません。最初に受け入れられたセットには 51 件のタスクが含まれています。
インフラストラクチャとパフォーマンスの分離
モデルは、4 ビットの Gemma 4 に小さな LoRA アダプターを付けたものです。これまでに行ったのは、小さなフィクスチャでの 1 回の更新だけです。最初の本格的な学習ステップはメモリ不足に陥りました。原因を突き止めてコードを修正しましたが、GPU 上での再計測はまだ行っていません。継続的な学習はまだ実行していないため、このプロジェクトでは、エージェントがまだ何かを学習したとは主張していません。
改善を再現可能にする。
- 01
タスクの系統を追跡する
リポジトリタスクは、ソースの出所および評価契約を運ぶ。重複のチェックと隔離により、疑わしい内容がトレーニング パスから排除されます。これにより、開発データと保留された評価の間の境界がツールで検査できるようになります。
- 02
見出しだけでなくテストも読む
テストの監査では、個々のケースの結果を保持し、矛盾する集計値は却下します。失敗、エラー、スキップされたケースは区別されたままです。プロセスが正常終了したことや、見栄えのよい集計値が、その裏にあるテストの証拠の代わりになることはありません。
- 03
アクションは変換し、結果は再実行する
別のエージェントフレームワークで得られた教師の軌跡を、固定されたルールに従って九つのツールの形式に変換します。ツールの実行結果は、あえて変換しません。結果はアクションを再実行して得なければならず、書き換えれば実行時の出力を捏造することになるからです。変換できない呼び出しが一つでもあれば、その軌跡全体を却下します。
これらは実装済みの評価と学習準備の仕組みです。リポジトリは、未知のリポジトリタスクでの学習による向上をまだ立証しておらず、このページでもコンテストの結果については何も主張していません。
実装準備記録を読む正直な限界。
- 大規模な学習はまだ行っていません。報告できる測定済みの改善はありません。
- 受け入れた 51 件のタスクはすべて開発中に参照されているため、ホールドアウトのテストには使えません。
- ライセンスのチェックは、各リポジトリが固定コミットの時点で何と記載しているかを記録するものです。観察結果であって、法的な確認ではありません。
ほかの島とのつながり。
開発中の研究ツール。このプロジェクトでは、まだ目に見えないリポジトリ タスクに関して学習されたパフォーマンスの向上が確立されていません。