Evaluar mejor a un agente
Hacer que los experimentos de software sean más fáciles de confiar.
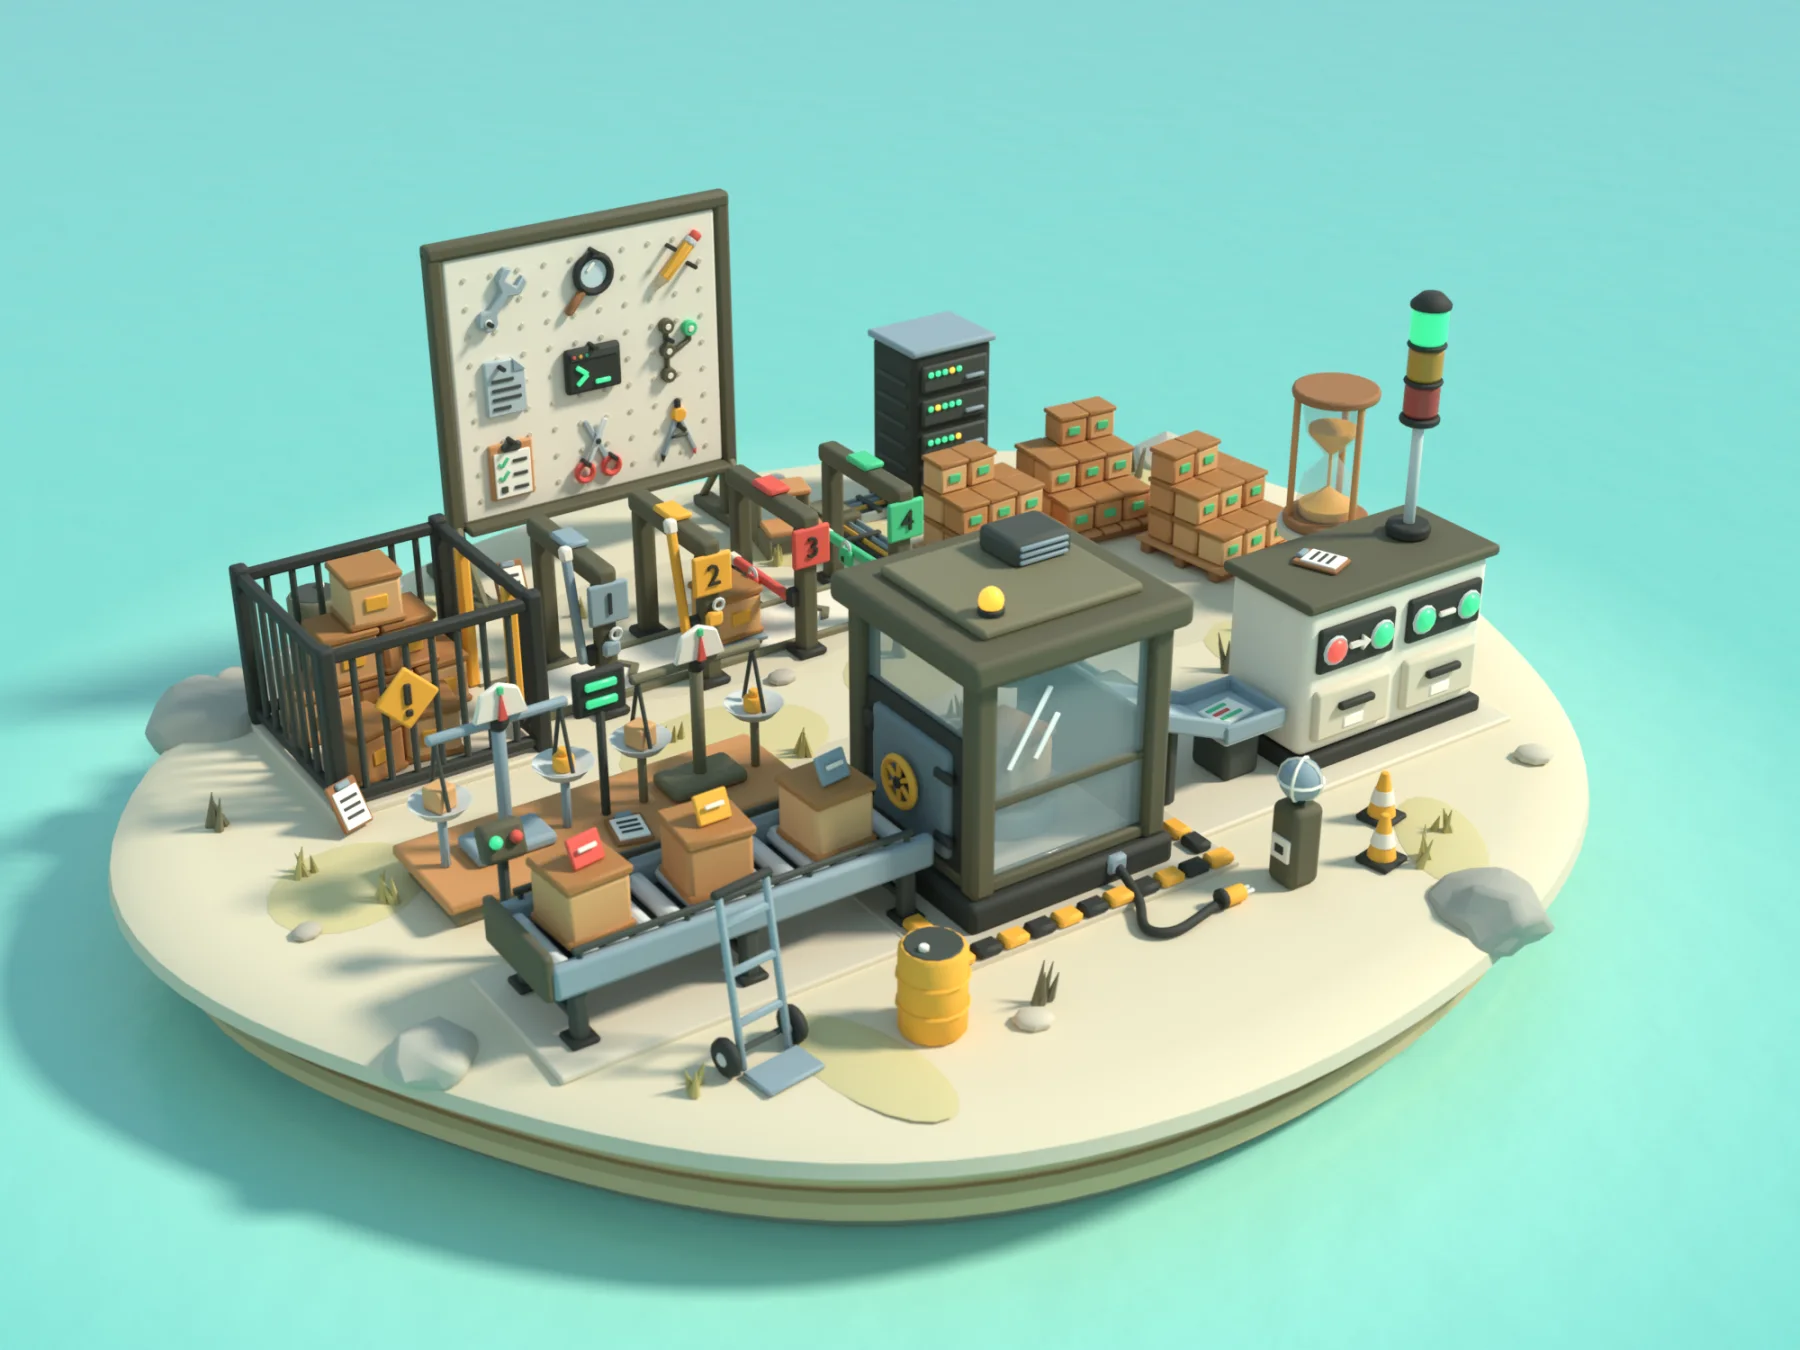
Una línea de pruebas, un corral de cuarentena y una pared con nueve herramientas.
Una ilustración creada en Blender para este sitio. Explica la idea; no son datos del proyecto.
Las imágenes, los diagramas y los vídeos originales conservan su idioma de origen.
Antes de preguntar si un agente de programación mejoró, conviene saber exactamente con qué se le evaluó. Este proyecto construye la infraestructura que hay detrás de esa pregunta para un agente de reparación de repositorios basado en Gemma 4: procedencia de las tareas, aislamiento de la evaluación, calendarios de entrenamiento deterministas y ejecuciones recuperables. Su regla de trabajo es que ninguna afirmación debe apoyarse en un paso no verificado.
La tarea que se evalúa
El agente recibe un repositorio de código abierto real y una incidencia reportada. Puede usar exactamente nueve herramientas, que cubren ejecutar comandos, leer y editar archivos, consultar el estado, navegar por la estructura del código y enviar un parche. Si el parche es correcto lo deciden pruebas que el agente nunca ve.
Una sala sellada y dos tipos de prueba
Cada tarea se ejecuta en un contenedor con la red desactivada. Una tarea válida debe fallar antes de la corrección y pasar después: las pruebas que fallaban deben pasar ahora, y las que pasaban deben seguir pasando. Analizadores para cinco frameworks de pruebas leen los resultados de cada caso y rechazan los resúmenes cuyos totales contradicen sus propios casos.
Saber de dónde vino cada tarea
De 32.079 filas candidatas, 4.818 cumplían los requisitos y 2.966 se seleccionaron y congelaron en particiones de entrenamiento, desarrollo y confirmación, separadas por repositorio y por propietario para que un mismo proyecto no pueda aparecer en ambos lados. Los archivos de licencia se comprobaron en el commit fijado de cada tarea, lo que detectó cuatro repositorios con texto copyleft bajo una etiqueta permisiva.
Cuatro filtros y dos verificadores
Los ejemplos de entrenamiento empiezan en cuarentena. Solo se admiten tras pasar cuatro filtros: derechos y atribución, aislamiento de particiones, validación en ejecución y alineación con la tarea. Después, un módulo de auditoría independiente recalcula cada magnitud sin compartir código con el cargador, de modo que ambos deben coincidir de forma independiente. El primer conjunto admitido contiene 51 tareas.
Separar la infraestructura del rendimiento
El modelo es un Gemma 4 de 4 bits con un pequeño adaptador LoRA. Hasta ahora ha recibido una sola actualización sobre un fixture diminuto; el primer paso de entrenamiento real se quedó sin memoria, se diagnosticó y se corrigió en un código que aún no se ha vuelto a medir en una GPU. No se ha ejecutado ningún entrenamiento sostenido, así que el proyecto no afirma que el agente haya aprendido nada todavía.
Hacer que una mejora sea reproducible.
- 01
Seguimiento del linaje de la tarea
Las tareas de repositorio conllevan contratos de evaluación y procedencia de fuentes. Los controles de superposición y la cuarentena mantienen el material cuestionable fuera del camino de formación. Esto hace que el límite entre los datos de desarrollo y la evaluación retenida sea algo que las herramientas puedan inspeccionar.
- 02
Lea las pruebas, no solo el titular.
La auditoría de pruebas conserva los resultados de cada caso y rechaza los recuentos agregados contradictorios. Los fallos, los errores y los casos omitidos se mantienen diferenciados. Una salida correcta del proceso o un recuento resumido atractivo no puede sustituir a la evidencia de las pruebas subyacentes.
- 03
Traducir las acciones, reproducir los resultados
Las trayectorias de un agente maestro de otro framework se convierten al formato de nueve herramientas según un conjunto fijo de reglas. Los resultados de las herramientas no se traducen, a propósito: deben proceder de reproducir la acción, porque reescribirlos equivaldría a fabricar salidas de ejecución. Una sola llamada intraducible descarta toda la trayectoria.
Son mecanismos implementados de evaluación y de preparación del entrenamiento. El repositorio aún no demuestra mejoras aprendidas en tareas de repositorio no vistas, y esta página no afirma ningún resultado de competición.
Leer el registro de preparación de la implementaciónLos límites, con honestidad.
- No se ha entrenado ningún modelo a escala. No hay ninguna mejora medida de la que informar.
- Las 51 tareas admitidas han estado expuestas durante el desarrollo, así que no pueden usarse como prueba reservada.
- Las comprobaciones de licencia registran lo que dice cada repositorio en un commit fijado. Son observaciones, no una autorización legal.
Dónde conecta esto.
 ZenithSync Assay PlannerComparte el nombre del proyecto, ZenithSync, y sus hábitos: fijar el protocolo y conservar los resultados negativos.
 Lenguaje en movimientoEscepticismo ante los instrumentos en ambos: a un verificador se le audita antes de creerle.
 CollegeAdvisorCada comprobante indica lo que no demuestra: la misma idea que “citar o abstenerse”.
Herramientas de investigación en desarrollo. El proyecto aún no establece mejoras de rendimiento aprendidas en tareas de repositorio invisibles.