ZenithSync Assay Planner
接下来实验应该测量什么?
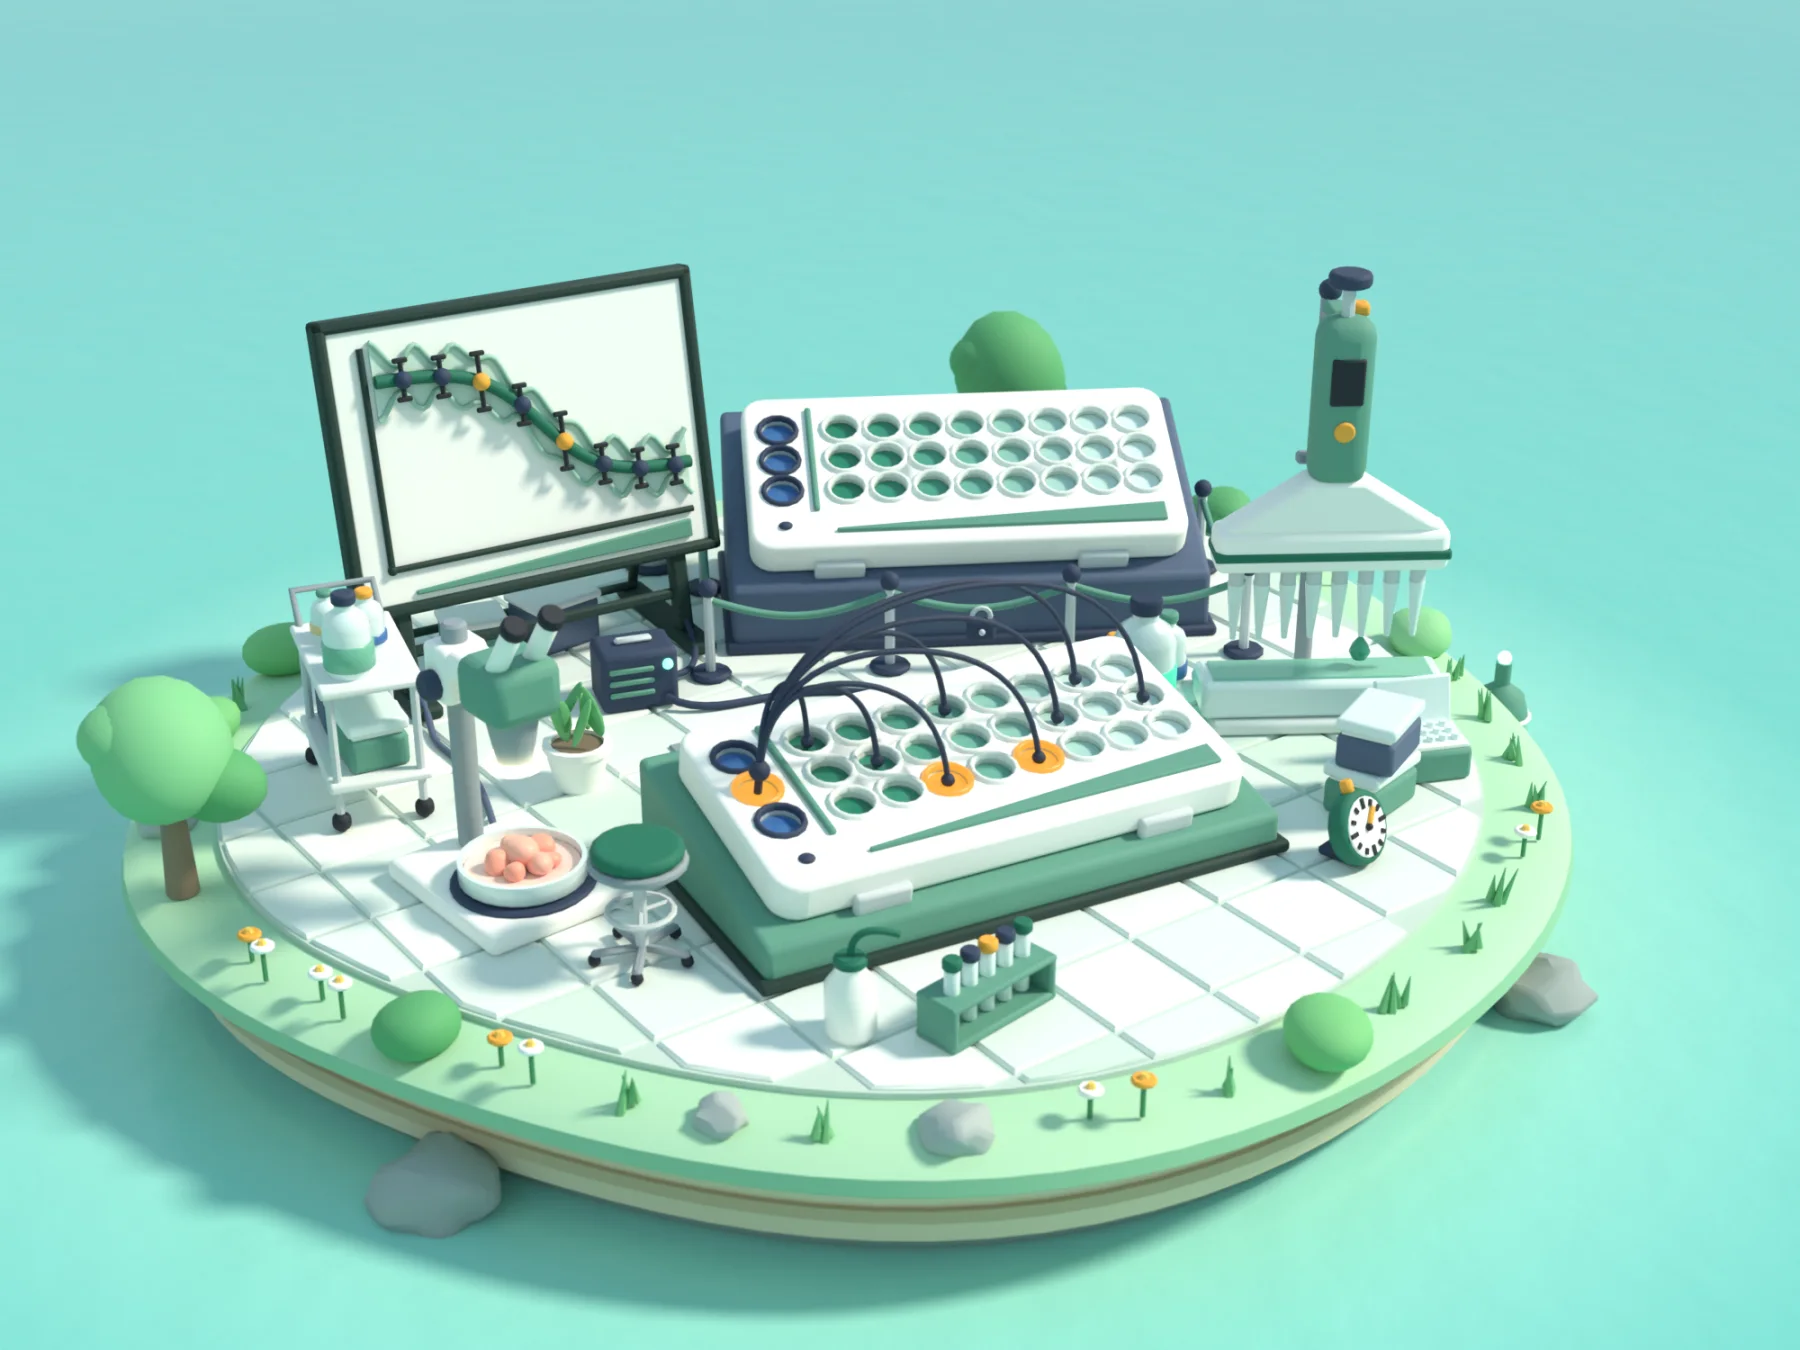
两块孔板、一条曲线,以及值得购买的三个孔。
为本站用 Blender 制作的示意图。它用于解释思路,并非项目数据。
项目原始图片、图表和视频保留原文。
每次测量都会占用实验预算的一部分。已有一个对照以及最低和最高剂量的测量结果时,实验室接下来应该购买哪几个孔,才能确定药物的剂量—响应曲线?我开发了一个规划器,它会考虑哪些已经知道、哪里仍有不确定性,以及一个共用对照如何同时影响多个处理组测量。
共享控制问题
处理组的响应是相对于一个实测对照来读取的。当多个响应共用这个参照时,它们的误差是相关的:如果对照读数偏高,所有对比值会一起偏低。规划器保留了这种依赖关系,而不是把对照当作完全已知;当增加一个对照孔比增加一个处理孔更有帮助时,它也可以选择购买对照孔。
从零开始的曲线
响应被建模为关于对数剂量的高斯过程,其核函数经过调整,使零剂量处的药物效应恰好为零。因此,对照不带有药物效应,但仍通过共享噪声携带信息。超参数在开发数据集上通过留一类器官交叉验证一次性选定(全部 28 折都选中了同一设置),随后冻结。
精确选择一批测量孔
在固定预算下,规划器搜索所有可能的孔组合,保留在计划剂量上平均不确定性最小的那一组。可互换的孔会被分组,因此一个代表可以代表许多等价组合:在确认实验中,13,408 个代表覆盖了 2,113,536 个子集。测试中的一个小反例说明了这一点的重要性:单独最好的孔并不总是最佳孔对的一部分。
在未见过的数据上检验结论
在打开确认数据集的响应之前,实验方案已被冻结并加上时间戳。该数据集每个情境有两块平行孔板:从一块中选孔,用另一块来评判。在来自 148 个类器官样本和 100 名患者的 6,496 个情境中,在同一模型下,精确选择相比随机选择将均方误差降低了 32.82%。相比更强的贪心基线,改进为 0.66%,这才是精确搜索优势的真实大小。
记录中保留了什么
在开发数据集上,同样的比较没有得出结论:所有 bootstrap 区间都包含零。更早的一次肝芯片预实验也没有得到正面结果。两者都和确认结果一起保留在代码仓库中,同时保留的还有第一次崩溃的评估运行,它被原样保存,仅针对序列化问题做了修订。
控制井是模型的一部分。
- 01
保持协方差
从多个处理组读数中减去同一个实测对照,会引入共享误差。若原始误差相互独立、方差为 s²,则对比噪声协方差为 R = s²(I + 11ᵀ):对角线上为 2s²,非对角线上为 s²。联合高斯模型保留了这种依赖关系;其误差比忽略这一依赖的消融模型低 11.36%。
- 02
搜索有限设计空间
优化器通过最小化设计剂量处的等权后验方差 C − C[:,A] C[A,A]⁻¹ C[A,:],在固定预算下选择一批孔。经验证可互换的孔会被分组,每种计数模式只评估一个代表。这减少了枚举量,但不会改变有界问题的最优解,并且在测试中与暴力搜索进行了核对。
- 03
冻结,然后评估
模型选择在使用另一项独立的公开类器官研究进行确认之前就已固定。精确、贪心和随机策略共用相同的预测模型和测量预算。推断时先在样本内对情境取平均、在患者内对样本取平均,然后对整名患者进行重抽样,因此重复的情境不会被当作独立证据。
协方差目标取决于设计和已观测孔的位置,而不取决于响应值。这是一种固定模型的批量设计:预测会随测量结果更新,但选择规则不会根据响应自适应调整。评估终点是原始对数“处理减对照”信号的误差,而不是细胞活力。
阅读数学和贡献审计诚实的边界。
- 这些是基于公开数据的回顾性结果。尚未证明能在真实实验室中节省成本。
- 名义上的 90% 区间覆盖了 98.05% 的留出读数,因此它们偏保守,而不是校准良好。
- 不声称任何临床收益、同行评审或竞赛名次。我是团队唯一的成员,也是唯一的审阅者。
仔细观察。
具有合成叙述的原始项目演练。审核阶段记录。 阅读文字记录↗
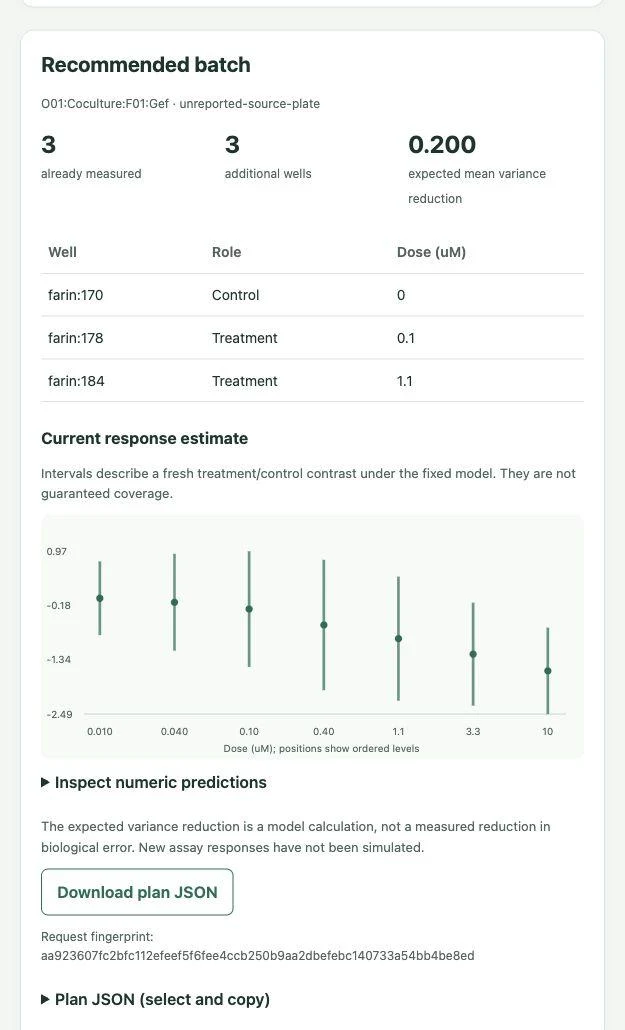
您可以检查的计划。
本地界面列出了选定的井、它们的角色以及模型的响应估计。可以下载结果以供进一步检查。
来自公共研究存储库的项目屏幕截图。