让语言动起来
研究单词和手语之间的距离。
一间动作采集工作室,以及让它保持诚实的测量工具。
为本站用 Blender 制作的示意图。它用于解释思路,并非项目数据。
项目原始图片、图表和视频保留原文。
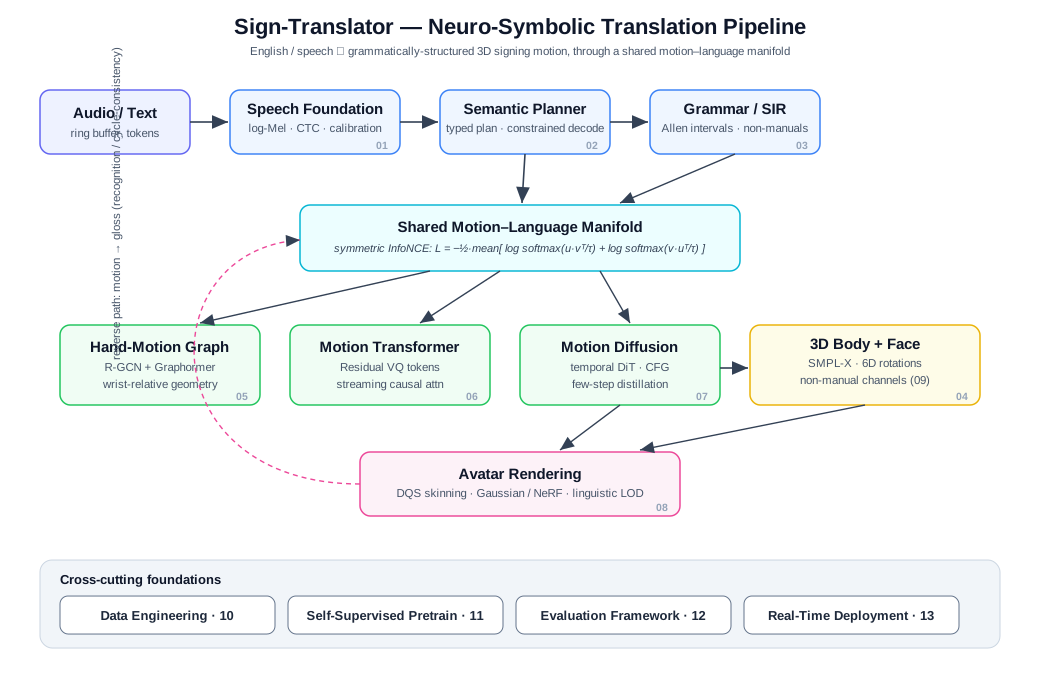
让科学教育更易获取,把我引向了一个困难的研究问题:语言如何与协调的动作联系起来?Sign-Translator 从工作室视频一路探索到渲染出的虚拟角色,同时始终把生成的动作与经过语言学验证的美国手语区分开。目前还没有聋人手语者评判过它的输出,凡是出现结果的地方,项目都会说明这一点。
不仅仅是一系列手部姿势
手语需要协调手、身体、面部、视线和时机。项目在同一个时钟上表示所有这些通道:以每秒 24 帧记录十一个通道,涵盖身体和手部旋转、头部运动、52 个面部系数、视线、眨眼和接触。每个值都带有是否真正观测到的标记,因此缺失数据始终可见,而不会被悄悄填补。
两台摄像机,一副骨架
动作来自从正面和侧面拍摄的工作室视频。姿态估计器在每个视角中找出关键点;利用手腕和手肘的运动同步两个视角,直接根据视频本身标定摄像机,再将对应点三角测量为三维坐标。这一阶段的一个发现是:当两台摄像机都固定对准手语者时,仅凭几何关系无法恢复焦距。在标定中加入刚性骨长项后,焦距误差从 40–47% 降到了 1% 以内。
动作的词汇表
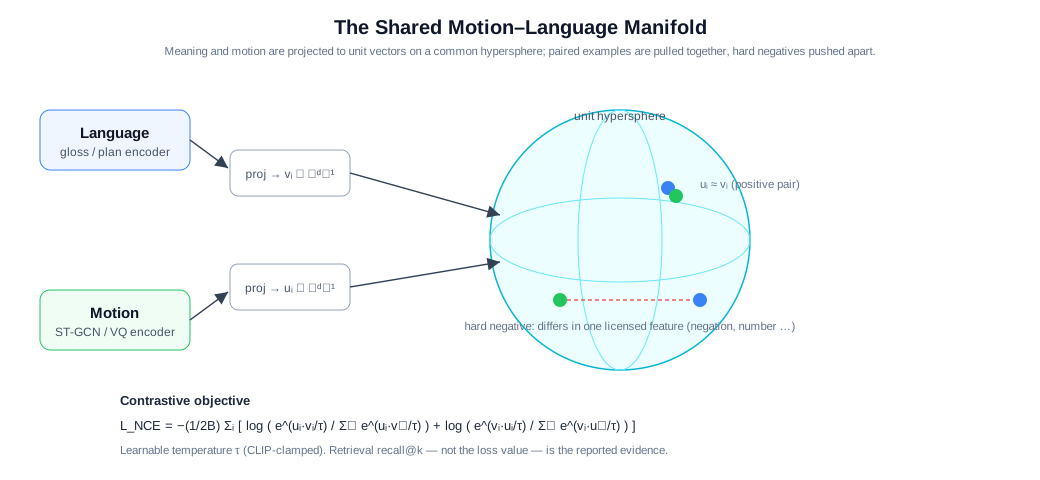
残差向量量化器把每一帧转化为 32 个离散编码:四个身体部位(身体、左手、右手、面部),每个部位经过八个阶段逐级细化。按部位拆分能保留单一坐标流会模糊掉的区别;从单一码本改为残差设计后,重建误差从约 19° 和 11 cm 降到约 8° 和 2 cm。
哪些没有奏效,又被什么取代
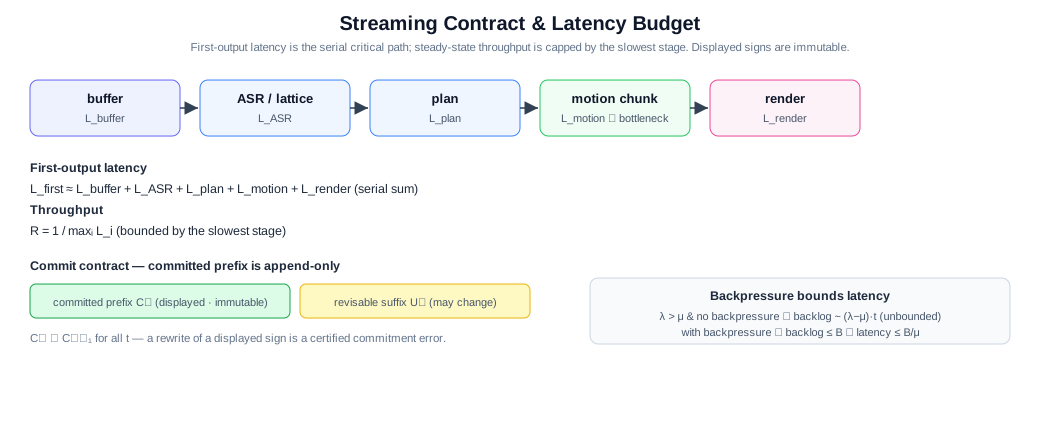
最初的计划是根据文本一次性生成整句动作。在项目的评估工具上,没有任何端到端生成器的表现能与空白动作拉开差距。目前采用的路线是组合:逐词单独生成,每个词采样十六次,保留识别器读得最好的样本,再按预测的时长把词连接起来。输出遵循英语语序,而这并不是 ASL 语法,项目对此明确说明。
解读量尺
生成的动作通过回译成英语并与源句比较来评分,并且始终与对照组并列:真实手语、空白动作、打乱顺序和错配句子。在一组只读取一次的全新句子上,组合生成得分 2.40,真实手语 4.03,空白动作 2.05。里程碑是 2.55。这一目标没有达到,结果在未重试的情况下照常公布。
语言必须在整个管道中生存。
- 01
将动议放在一个时钟上
利用关键点运动对齐 How2Sign 的正面和侧面视频,然后标定摄像机、三角测量位置并拟合关节旋转。重投影和刚性骨骼检查对重建加以约束。这些是基于视频的估计并保留了数据来源,而不是动作捕捉的真实值。
- 02
预测编码,而非坐标
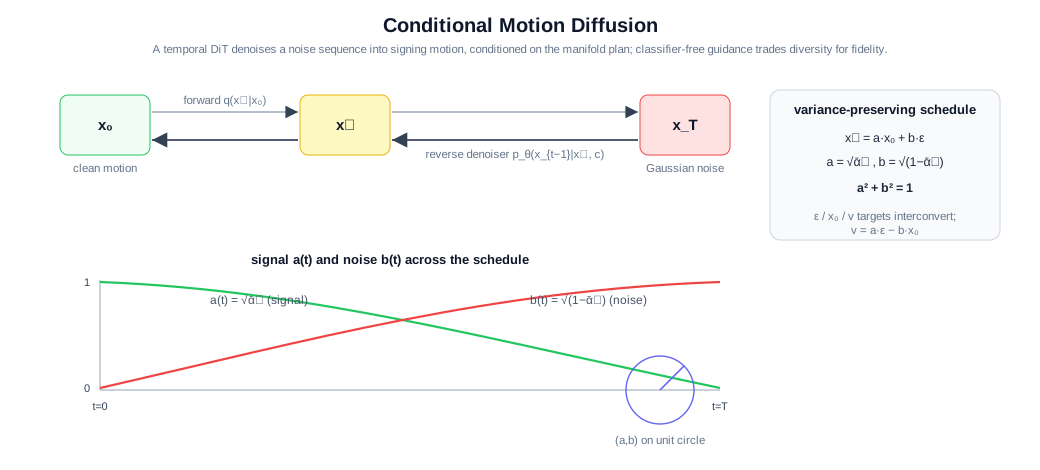
自回归 Transformer 根据文本预测残差编码:由一个基于帧的因果时序模型、一个字节级文本编码器,以及一个作用于八个阶段的较小深度模型组成。早期自由生成的样本被识别出的比例远低于单步预测所显示的水平;通过裁剪、历史丢弃(history dropout)和掩码损失,孤立单词上的大部分差距得以弥合。
- 03
测试分数测量的是什么
早期的检索评估器给旋转全部归零的动作打出了出人意料的高分:片段时长泄露了答案。采用固定的两秒窗口、随机偏移和仅基于时长的对照后,这条捷径就可以被检验。此后每一个评估工具在被允许为生成器打分之前,都会接受同样的审视。
发布标准在任何人工评分之前就已确定:聋人评分者对生成句子的理解率必须至少达到 70%,且与真实手语相差不超过十个百分点。这项研究已经设计好,但尚未开展。在此之前,这里的任何内容都不能支持“可理解的 ASL”这一说法。
阅读连续训练实验诚实的边界。
- 还没有聋人手语者评估过生成的动作。自动评分只是一种替代指标,并不等于理解。
- 输出遵循英语语序,没有对 ASL 语法建模。
- 模型权重未公开,该系统也不是已部署的翻译器。
从观察到运动。
英文音频。字幕支持所有十种网站语言;翻译是机器辅助的。
阅读文字记录
00:00 这些好奇心最终把我带到了 Sign-Translator。
00:03 来自两台摄像机的射线在关节处相交,从而确定关节的三维位置。
00:08 利用骨骼长度不变这一约束,焦距误差从超过 40% 缩小到了 1% 以内。
00:14 接着,动作被压缩成类似词汇表的编码,再由 Transformer 根据英语生成这些编码。
00:21 然后,几乎所有尝试都失败了。
00:22 整句动作生成器的可读性,并不比完全静止的基线更好。
00:26 其中一个模型通过了全部 95 项动作检查,却仍然无法表达一个句子。
00:32 所以,现在系统逐词生成动作,再将片段拼接起来。
00:37 遇到不认识的词,它就直接跳过。
00:39 评估时,另一个模型把动作重新解读为英语。
00:43 空白动作得分为 2.05,生成动作得分为 2.4,真实手语约为 4。
00:49 提升很小,但这是一个开始。
00:51 感谢观看。
播放无法开始。尝试视频控件或下载视频。
我的作品集电影的摘录:手部地标、重建、生成的运动和评估限制。渲染的头像和自动评分展示了正在进行的研究工作;它们不建立手语的可理解性。
从言
到 运动。
姿势只是
开始。
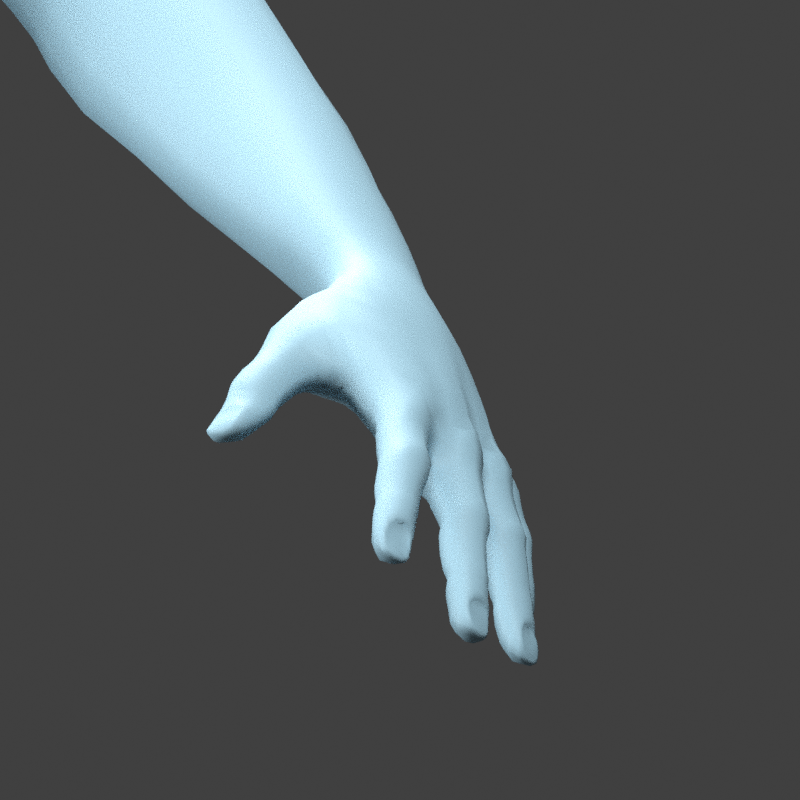
运动模型最终必须驱动主体。这个原始的手工关节渲染来自存储库的装备检查:仔细观察化身背后的几何形状和关节行为。
静态骨骼绑定测试。它没有描述翻译的句子。