讓語言動起來
研究單字和手語之間的距離。
一間動作擷取工作室,以及讓它保持誠實的量測工具。
為本網站以 Blender 製作的插圖。它用來說明概念,並非專案的資料。
專案原始圖片、圖表和影片保留原文。
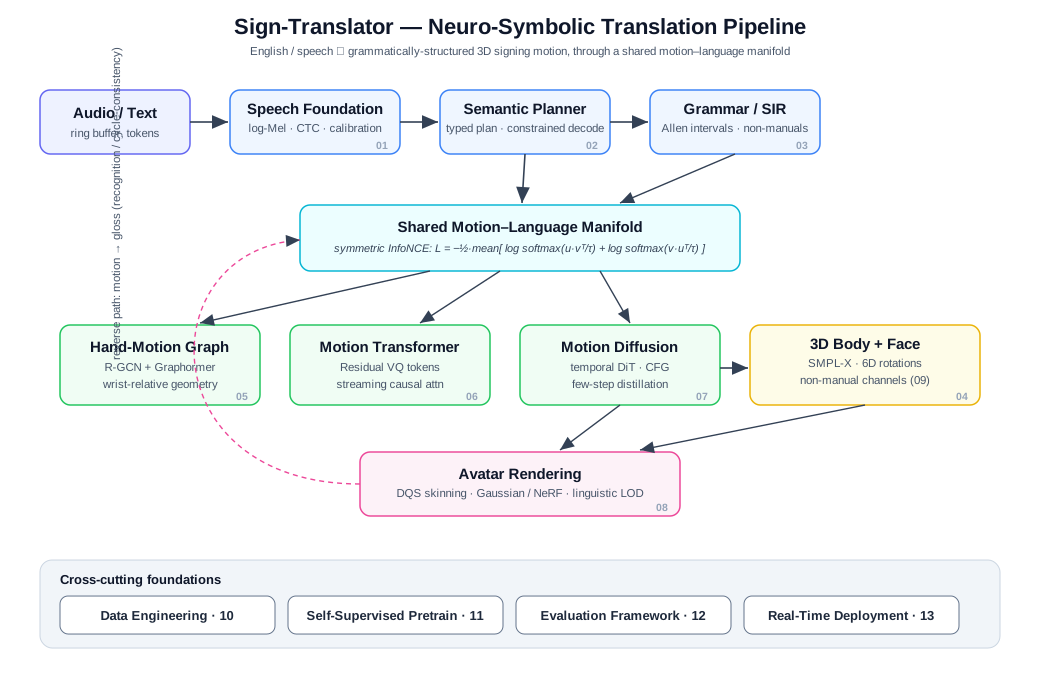
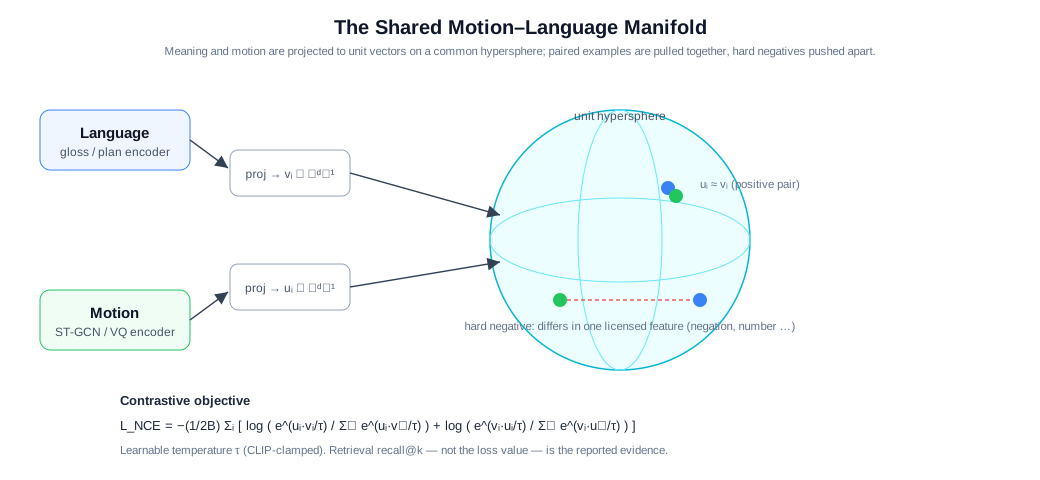
讓科學教育更容易取得,引領我走向一個困難的研究問題:語言如何與協調的動作連結?Sign-Translator 從工作室影片一路探索到算圖的虛擬角色,同時清楚區分生成的動作與經過語言學驗證的美國手語。目前還沒有任何聾人手語者評判過它的輸出,專案在每一處呈現結果的地方都會說明這一點。
不只是一系列手部姿勢
手語需要協調雙手、身體、臉部、視線與時機。本專案把這些全部放在同一個時鐘上表示:以每秒 24 影格記錄十一個通道,涵蓋身體與手部旋轉、頭部動作、52 個臉部係數、視線、眨眼與接觸。每個數值都帶有是否實際觀測到的標記,讓缺失的資料保持可見,而不是被默默補上。
兩台攝影機,一副骨架
動作來自從正面與側面拍攝的工作室影片。姿態估計器在每個視角中找出關鍵點;兩個視角依手腕與手肘的動作同步,攝影機直接從影片本身校準,相對應的點再經三角測量重建為 3D。這個階段的一項發現:當兩台攝影機都固定對準手語者時,無法僅從幾何關係求得焦距。在校準中加入剛性骨長項後,焦距誤差從 40–47% 降到 1% 以內。
動作的詞彙
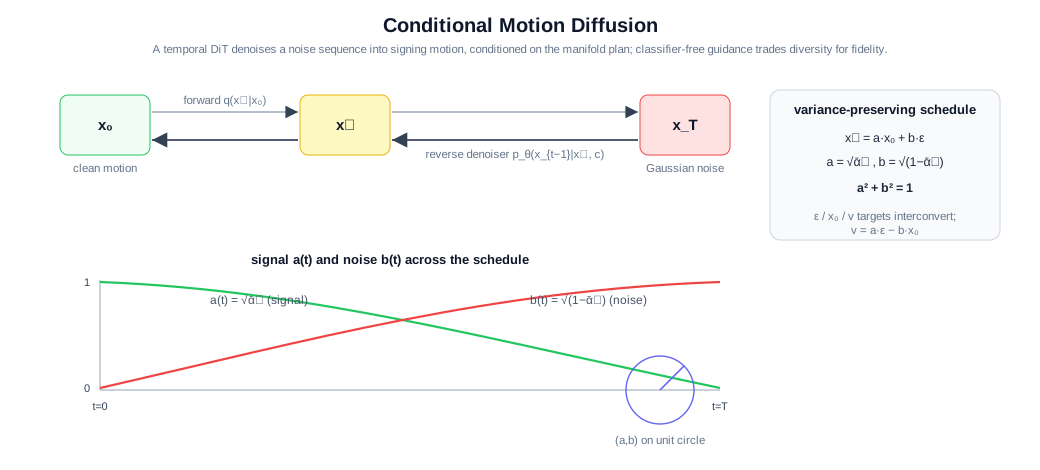
殘差向量量化器把每一影格轉換成 32 個離散編碼:四個身體部位(身體、左手、右手、臉部),各經過八個階段逐步細化。按部位拆分,能保留單一座標串流會模糊掉的差異;從單一碼本改為殘差設計後,重建誤差從約 19° 和 11 cm 降至約 8° 和 2 cm。
哪些沒有成功,又以什麼取代
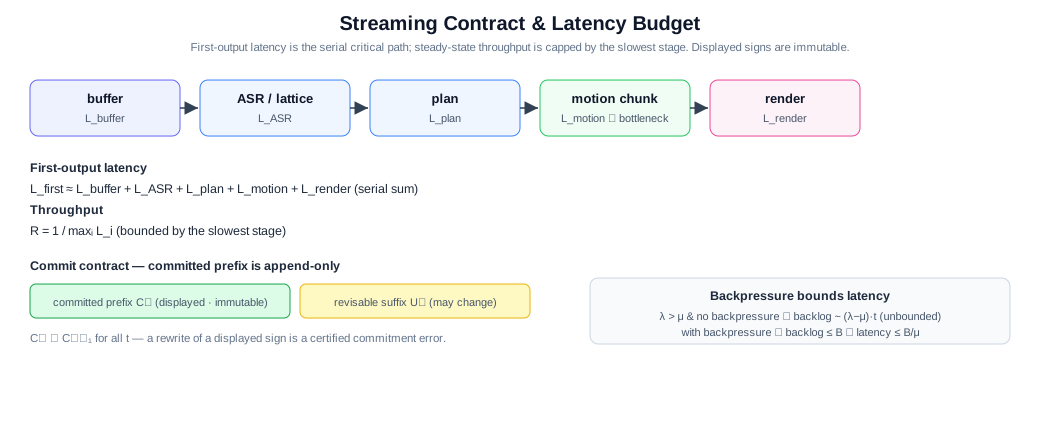
最初的計畫是從文字一次生成整句的動作。在專案的量測工具上,沒有任何端到端生成器能與空白動作區分開來。目前的做法是組合:每個詞分別生成,各取樣十六次,保留辨識器解讀得最好的樣本,再依預測的時間把詞串接起來。輸出依照英文語序,而那不是 ASL 的語法,專案也清楚說明了這一點。
解讀量尺
生成的動作會被翻譯回英文,再與原句比較來評分,而且一律與對照組並列:真實手語、空白動作、打亂順序,以及錯誤的句子。在一組只讀取一次的全新句子上,組合式方法得 2.40 分,真實手語 4.03 分,空白動作 2.05 分。里程碑是 2.55 分。這個目標沒有達成,結果照樣公布,沒有重試。
語言必須在整個管道中生存。
- 01
將動議放在一個時鐘上
利用關鍵點動作對齊 How2Sign 的正面與側面影片,接著校準攝影機、三角測量位置並擬合關節旋轉。重投影與剛性骨骼檢查約束了重建結果。這些是由影片推導的估計值,並保留了資料來源,而非動作擷取的真實資料(ground truth)。
- 02
預測編碼,而非座標
自迴歸 Transformer 根據文字預測殘差編碼:包括一個跨影格的因果時序模型、一個位元組層級的文字編碼器,以及一個在八個階段上運作的較小深度模型。早期自由生成的樣本被辨識出的比例,遠低於單步預測所顯示的水準;經過裁剪、歷史丟棄(history dropout)與遮罩損失後,單字層級的這個落差大部分已經縮小。
- 03
測驗分數測量的是什麼
較早的一個檢索評估器,竟對旋轉全部歸零的動作給出不錯的分數:片段長度洩漏了答案。固定的兩秒視窗、隨機偏移,以及只看長度的對照組,讓這條捷徑可以被檢驗。之後的每一項量測工具在獲准為生成器評分之前,都會先接受同樣的檢視。
發布門檻在任何人工評分之前就已確定:聾人評分者對生成句子的理解率必須至少達 70%,且與真實手語的差距在十個百分點以內。這項研究已經設計完成,但尚未進行。在那之前,這裡的任何內容都不足以支持「可理解的 ASL」這項主張。
閱讀連續訓練實驗誠實的邊界。
- 還沒有任何聾人手語者評估過生成的動作。自動評分只是替代指標,不代表理解。
- 輸出依照英文語序,並未建模 ASL 語法。
- 模型權重尚未公開,本系統也不是已部署的翻譯器。
從觀察到運動。
英文音頻。字幕支援所有十種網站語言;翻譯是機器輔助的。
閱讀文字記錄
00:00 這些好奇心最終把我帶到了 Sign-Translator。
00:03 來自兩台攝影機的射線在關節處相交,從而確定關節的三維位置。
00:08 利用骨骼長度不變這一約束,焦距誤差從超過 40% 縮小到了 1% 以內。
00:14 接著,動作被壓縮成類似詞彙表的編碼,再由 Transformer 根據英語生成這些編碼。
00:21 然後,幾乎所有嘗試都失敗了。
00:22 整句動作生成器的可讀性,並不比完全靜止的基準更好。
00:26 其中一個模型通過了全部 95 項動作檢查,卻仍然無法表達一個句子。
00:32 所以,現在系統逐詞生成動作,再將片段拼接起來。
00:37 遇到不認識的詞,它就直接跳過。
00:39 評估時,另一個模型把動作重新解讀為英語。
00:43 空白動作得分為 2.05,生成動作得分為 2.4,真實手語約為 4。
00:49 提升很小,但這是一個開始。
00:51 感謝觀看。
播放無法開始。嘗試視訊控製或下載影片。
我的作品集電影的摘錄:手部地標、重建、生成的運動和評估限制。渲染的頭像和自動評分展示了正在進行的研究工作;它們不建立手語的可理解性。
從言
到 運動。
姿勢只是
開始。
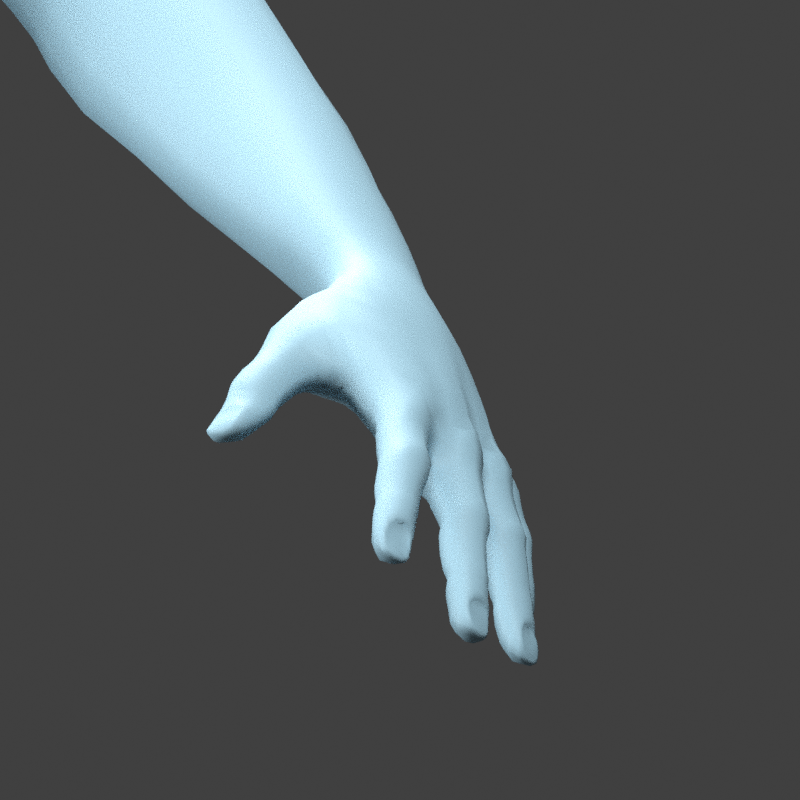
運動模型最終必須驅動主體。這個原始的手工關節渲染來自儲存庫的裝備檢查:仔細觀察化身背後的幾何形狀和關節行為。
靜態骨骼綁定測試。它沒有描述翻譯的句子。